En data science, on cherche souvent à savoir si deux variables évoluent ensemble.
Par exemple :
- le prix d’un logement augmente-t-il avec sa surface ?
- le chiffre d’affaires augmente-t-il avec le trafic d’un site ?
- les ventes diminuent-elles lorsque le prix augmente ?
- l’âge d’un client est-il lié à son niveau de dépense ?
Pour répondre à ce type de question, on utilise souvent un coefficient de corrélation.
Deux méthodes sont particulièrement courantes : Pearson et Spearman.
Elles produisent toutes les deux un coefficient compris entre -1 et 1, mais elles ne mesurent pas exactement la même chose :
- Pearson mesure principalement les relations linéaires ;
- Spearman mesure les relations monotones, même lorsqu’elles ne sont pas linéaires.
Comprendre cette différence est important, car une mauvaise utilisation de Pearson peut parfois faire passer une relation forte pour une relation faible.
Qu’est-ce qu’une corrélation ?#
Une corrélation mesure à quel point deux variables évoluent ensemble.
Le coefficient de corrélation est généralement compris entre \(-1\) et \(1\).
- une valeur proche de 1 indique une forte relation positive ;
- une valeur proche de -1 indique une forte relation négative ;
- une valeur proche de 0 indique une absence de relation du type mesuré par le coefficient.
Par exemple, si la corrélation entre la surface d’un appartement et son prix est positive, cela signifie que les grands appartements ont généralement tendance à être plus chers.
Corrélation ≠ causalité
Une forte corrélation entre deux variables ne signifie pas que l’une provoque l’autre.
Deux variables peuvent être corrélées :
- par hasard,
- parce qu’une troisième variable influence les deux,
- ou parce qu’elles sont effectivement liées.
La corrélation permet donc d’identifier une association, pas de démontrer une causalité.
La corrélation de Pearson#
Le coefficient de Pearson est probablement la mesure de corrélation la plus connue.
Il est défini par :
\[ r = \frac{ \sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y}) }{ \sqrt{ \sum_{i=1}^{n}(x_i-\bar{x})^2 \sum_{i=1}^{n}(y_i-\bar{y})^2 } } \]
Il peut également être vu comme une covariance normalisée :
\[ r = \frac{\operatorname{Cov}(X,Y)} {\sigma_X \sigma_Y} \]
L’idée principale est simple : Pearson mesure la force d’une relation linéaire entre deux variables.
Si les observations suivent approximativement une droite croissante, Pearson sera proche de 1.
Si elles suivent une droite décroissante, Pearson sera proche de -1.
Le problème des relations non linéaires#
Supposons maintenant que (Y) augmente systématiquement lorsque (X) augmente, mais selon une courbe.
Par exemple :
\[ Y = \log(X) \]
ou :
\[ Y = e^X \]
Dans les deux cas, \(Y\) évolue toujours dans le même sens que \(X\).
La relation est donc très forte, mais elle n’est pas linéaire.
Pearson peut alors sous-estimer la force de cette relation.
C’est précisément dans ce genre de situation que Spearman devient intéressant.
La corrélation de Spearman#
La corrélation de Spearman fonctionne différemment.
Au lieu de calculer la corrélation directement sur les valeurs, elle commence par transformer les observations en rangs.
Prenons par exemple :
| X | Rang de X | Y | Rang de Y |
|---|---|---|---|
| 10 | 1 | 3 | 1 |
| 20 | 2 | 8 | 2 |
| 30 | 3 | 20 | 3 |
| 40 | 4 | 50 | 4 |
Les écarts entre les valeurs de \(Y\) sont très différents, mais leur ordre reste parfaitement conservé.
Spearman calcule essentiellement une corrélation de Pearson sur ces rangs :
\[ \rho_s = \operatorname{Corr}(\operatorname{rank}(X), \operatorname{rank}(Y)) \]
Lorsque les rangs sont parfaitement conservés, Spearman vaut 1.
Peu importe que la relation forme une droite, une logarithmique ou une exponentielle.
Ce qui compte principalement est l’ordre des observations.
Qu’est-ce qu’une relation monotone ?#
C’est la notion essentielle pour comprendre Spearman.
Une relation est monotone croissante lorsque, globalement, \(Y\) ne diminue pas quand \(X\) augmente.
Inversement, elle est monotone décroissante lorsque \(Y\) ne croît pas quand \(X\) augmente.
Une relation linéaire croissante est donc monotone :
\[ Y = 2X \]
Mais une relation logarithmique peut également être monotone :
\[ Y = \log(X) \]
Tout comme une relation exponentielle :
\[ Y = e^X \]
Elles ne sont pas linéaires, mais elles conservent toutes un ordre croissant.
C’est pourquoi Spearman peut détecter des relations que Pearson représente moins bien.
Linéaire vs monotone
Une relation linéaire peut être représentée par une droite.
Une relation monotone signifie simplement que les variables évoluent toujours globalement dans le même sens.
Toute relation linéaire avec une pente non nulle est monotone, mais une relation monotone n’est pas nécessairement linéaire.
Pearson vs Spearman#
La différence fondamentale peut être résumée ainsi :
| Critère | Pearson | Spearman |
|---|---|---|
| Utilise directement les valeurs | ✅ | ❌ |
| Utilise les rangs | ❌ | ✅ |
| Mesure une relation linéaire | ✅ | ✅ |
| Mesure une relation monotone non linéaire | ❌ | ✅ |
| Sensible aux valeurs extrêmes | Oui | Beaucoup moins |
| Nécessite une relation linéaire pour être pertinent | Oui | Non |
En pratique :
Pearson s’intéresse aux distances entre les valeurs, alors que Spearman s’intéresse surtout à leur ordre.
C’est cette différence qui explique une grande partie de leurs comportements.
L’impact des outliers#
Pearson utilise directement les valeurs numériques.
Une observation extrêmement éloignée des autres peut donc modifier fortement :
- la moyenne,
- la covariance,
- et finalement le coefficient de corrélation.
Pearson peut ainsi être très sensible aux outliers.
Spearman utilise les rangs. Une valeur passant de 1 000 à 1 000 000 restera éventuellement simplement la plus grande observation du dataset.
Son rang ne change pas.
Spearman est donc généralement beaucoup plus robuste aux valeurs extrêmes.
Cela ne signifie pas qu’il est totalement insensible aux outliers : une observation aberrante peut aussi modifier l’ordre des observations. Son impact est simplement beaucoup moins directement lié à son amplitude.
Attention aux relations en U#
Spearman n’est pas pour autant capable de détecter toutes les relations non linéaires.
Prenons :
\[ Y = X^2 \]
avec des valeurs de \(X\) positives et négatives.
Lorsque \(X\) passe de valeurs négatives vers 0, \(Y\) diminue. Puis lorsque \(X\) devient positif et augmente, \(Y\) augmente.
La relation forme donc un U.
Elle n’est pas monotone.
Dans cette situation :
- Pearson peut être proche de 0 ;
- Spearman peut également être proche de 0 ;
- alors qu’il existe pourtant une relation déterministe très forte entre \(X\) et \(Y\).
Une corrélation proche de zéro ne signifie donc pas nécessairement que deux variables sont indépendantes.
Cela signifie seulement que le coefficient utilisé ne détecte pas de relation suffisamment forte du type qu’il mesure.
C’est une raison importante pour laquelle la visualisation des données reste indispensable.
Astuce pratique en data science#
Lors d’une analyse exploratoire, une approche intéressante consiste à calculer Pearson et Spearman.
La comparaison des deux coefficients peut donner des informations sur la structure de la relation.
Pearson ≈ Spearman#
Si les deux coefficients sont élevés et relativement proches, la relation est probablement assez bien représentée par une relation linéaire.
Par exemple :
Pearson  = 0.91
Spearman = 0.93
Il est alors raisonnable de penser que les deux variables évoluent ensemble de manière approximativement linéaire.
Spearman > Pearson#
Si Spearman est nettement supérieur à Pearson :
Pearson  = 0.55
Spearman = 0.91
cela peut indiquer une relation monotone mais non linéaire.
Par exemple :
- logarithmique,
- exponentielle,
- ou plus généralement une courbe qui conserve l’ordre des observations.
Cela peut être un signal intéressant pour explorer :
- une transformation logarithmique,
- une transformation de variable,
- ou simplement une relation non linéaire entre les features.
Il faut toutefois le vérifier graphiquement : une différence entre les deux coefficients n’est pas, à elle seule, une preuve de non-linéarité.
Pearson ≈ Spearman ≈ 0#
Si les deux coefficients sont proches de zéro, il n’existe probablement pas de relation linéaire ou monotone forte.
Mais cela ne permet pas de conclure qu’il n’existe aucune relation.
Une relation :
- en U,
- périodique,
- par morceaux,
- ou plus généralement non monotone,
peut être totalement invisible pour Pearson comme pour Spearman.
Toujours visualiser les données#
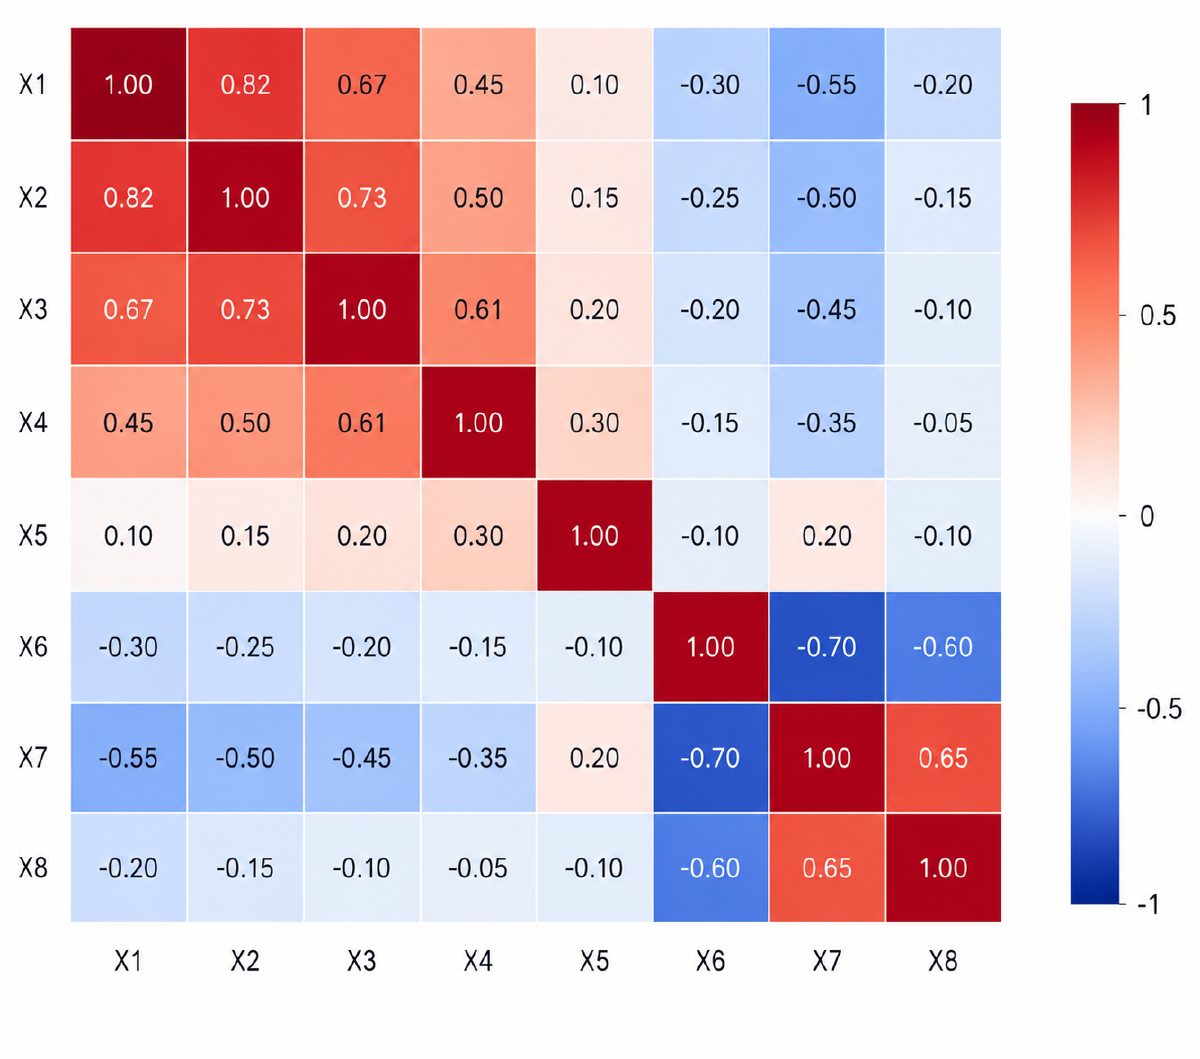
Calculer une matrice de corrélation est très pratique, notamment lorsqu’un dataset contient beaucoup de variables.
Mais une corrélation reste un résumé numérique.
Deux datasets très différents peuvent produire des coefficients de corrélation similaires.
Une bonne analyse exploratoire combine donc les coefficients avec des visualisations comme :
- scatter plots,
- pair plots,
- distributions,
- courbes de tendance.
En pratique, le réflexe devrait être :
calculer → comparer → visualiser → interpréter
et non simplement regarder le coefficient le plus élevé.
Quel coefficient utiliser ?#
Utiliser Pearson lorsque :#
- les variables sont quantitatives ;
- on cherche spécifiquement une relation linéaire ;
- les scatter plots suggèrent une forme approximativement linéaire ;
- les valeurs extrêmes ne dominent pas l’analyse.
Utiliser Spearman lorsque :#
- la relation semble monotone mais pas nécessairement linéaire ;
- les données contiennent des valeurs extrêmes importantes ;
- les variables sont naturellement ordinales ;
- on s’intéresse davantage à l’ordre des observations qu’aux distances exactes entre leurs valeurs.
Il n’est d’ailleurs pas toujours nécessaire de choisir immédiatement entre les deux.
En analyse exploratoire, calculer les deux est souvent très instructif.
Exemple avec Python#
Avec Pandas, le calcul est très simple :
pearson_corr = df.corr(method="pearson")
spearman_corr = df.corr(method="spearman")
On peut ensuite comparer les deux matrices :
difference = spearman_corr - pearson_corrLes couples de variables présentant une différence importante peuvent être de bons candidats à une inspection plus approfondie.
Avec SciPy, on peut également calculer les coefficients individuellement :
from scipy.stats import pearsonr, spearmanr

pearson = pearsonr(x, y)
spearman = spearmanr(x, y)

print(pearson.statistic)
print(spearman.statistic)
Il est ensuite particulièrement utile de regarder le scatter plot correspondant avant de tirer une conclusion.
Est-ce utile en machine learning ?#
Oui, principalement pendant la phase d’Exploratory Data Analysis (EDA).
Les corrélations peuvent notamment aider à :
- comprendre les relations entre les features ;
- identifier les variables fortement associées à la target ;
- détecter des variables très corrélées entre elles ;
- repérer certaines redondances ;
- identifier des relations potentiellement non linéaires ;
- orienter le feature engineering.
Mais une faible corrélation ne signifie pas forcément qu’une feature est inutile.
Une variable peut avoir une relation complexe avec la target et être très utile pour un modèle comme :
- Random Forest,
- XGBoost,
- LightGBM,
- ou d’autres modèles capables d’exploiter des interactions et des relations non linéaires.
Il faut donc éviter de supprimer automatiquement une feature simplement parce que sa corrélation de Pearson ou de Spearman est faible.
En conclusion#
Pearson et Spearman répondent à deux questions légèrement différentes.
Pearson mesure principalement la force d’une relation linéaire entre deux variables.
Spearman mesure la force d’une relation monotone en travaillant sur les rangs plutôt que directement sur les valeurs.
En pratique :
- Pearson élevé + Spearman élevé : probablement une relation forte, potentiellement linéaire ;
- Spearman nettement supérieur à Pearson : possible relation monotone non linéaire ;
- Pearson et Spearman faibles : pas de relation linéaire ou monotone forte détectée, mais une relation plus complexe reste possible.
La meilleure pratique en data science reste donc de ne pas considérer la corrélation comme une réponse définitive.
Elle constitue plutôt un outil d’exploration.
Calculer Pearson et Spearman, comparer leurs résultats puis visualiser les données permet généralement de comprendre beaucoup mieux les relations présentes dans un dataset.