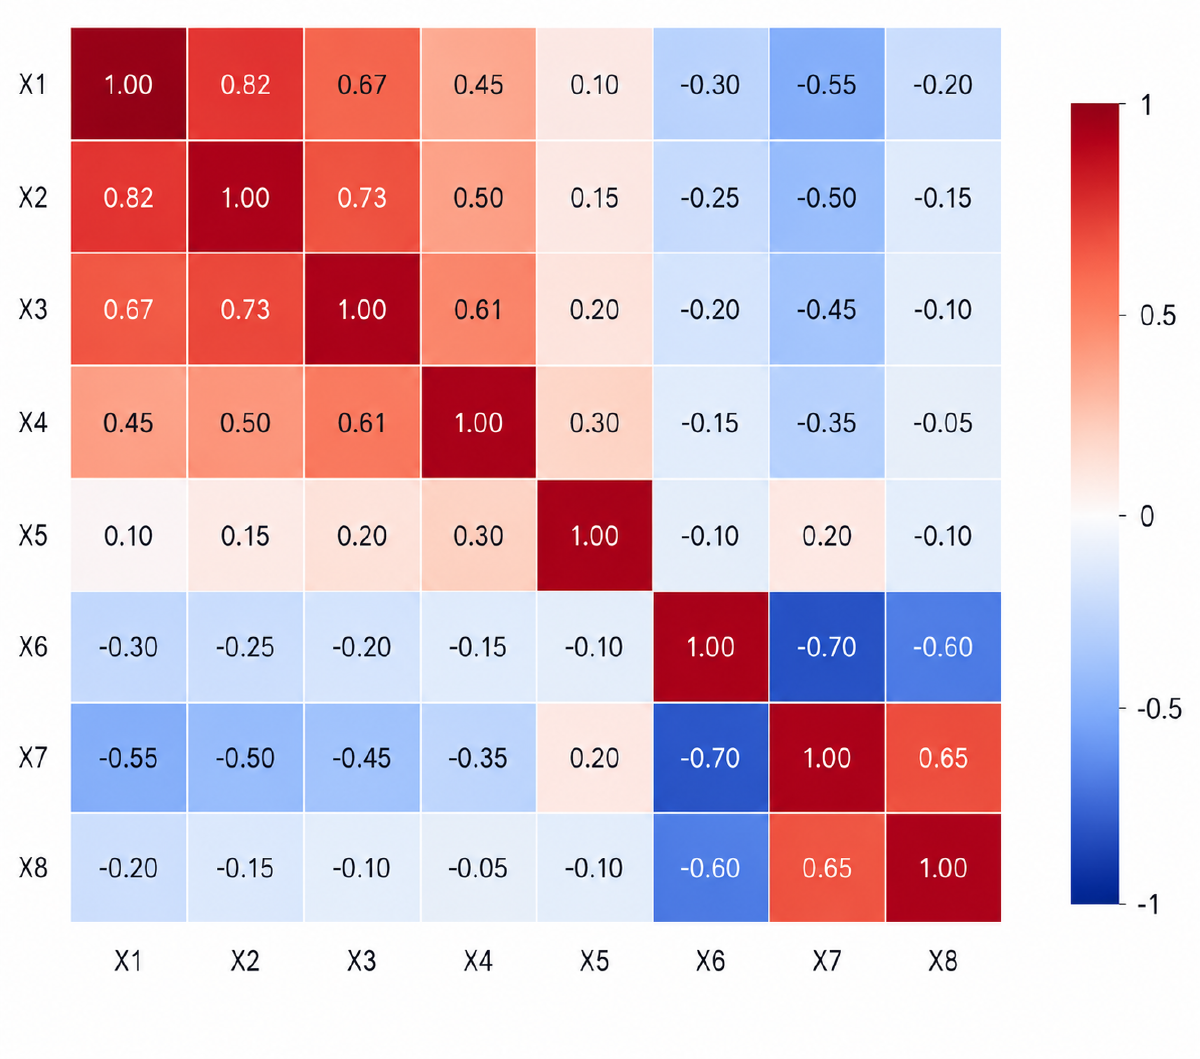
Un coefficient de corrélation permet de mesurer l’association entre deux variables.
Par exemple, la surface d’un logement est-elle associée à son prix ? Le montant des ventes évolue-t-il avec les dépenses publicitaires ?
Deux coefficients sont particulièrement utilisés :
- Pearson, pour mesurer une association linéaire ;
- Spearman, pour mesurer une association monotone, à partir des rangs.
Tous deux prennent des valeurs comprises entre -1 et 1 :
- 1 : association positive parfaite du type mesuré ;
- -1 : association négative parfaite ;
- 0 : aucune association détectée par le coefficient utilisé.
Une corrélation proche de zéro ne signifie donc pas nécessairement que les variables sont indépendantes.
1. Deux coefficients, deux approches#
Corrélation de Pearson#
Le coefficient de Pearson mesure la force et le sens d’une association linéaire entre deux variables quantitatives.
Il correspond à une covariance normalisée :
$$ r = \frac{\operatorname{Cov}(X,Y)}{\sigma_X \sigma_Y} $$
Avec :
- \(\operatorname{Cov}(X,Y)\) : covariance entre les variables ;
- \(\sigma_X\) et \(\sigma_Y\) : écarts-types des variables.
Lorsque les observations suivent parfaitement une droite croissante, Pearson vaut 1. Pour une droite décroissante, il vaut -1.
Attention : Pearson reste calculable pour une relation non linéaire. Simplement, il ne résume que son association linéaire.
Corrélation de Spearman#
Spearman mesure une association monotone : lorsque l’une des variables augmente, l’autre tend à évoluer dans un même sens, sans nécessairement suivre une droite.
Contrairement à Pearson, il utilise les rangs des observations, et non directement leurs valeurs.
$$ \rho_s = \operatorname{Corr}(\operatorname{rang}(X),\operatorname{rang}(Y)) $$
Exemple :
| X | Y | Rang X | Rang Y |
|---|---|---|---|
| 10 | 3 | 1 | 1 |
| 20 | 8 | 2 | 2 |
| 30 | 20 | 3 | 3 |
| 40 | 50 | 4 | 4 |
Les écarts entre les valeurs sont différents, mais leur ordre est parfaitement conservé.
Spearman vaut donc 1, même si les points ne sont pas alignés sur une droite.
En présence de valeurs identiques, les rangs ex æquo sont généralement remplacés par leurs rangs moyens.
2. Trois situations pour comprendre#
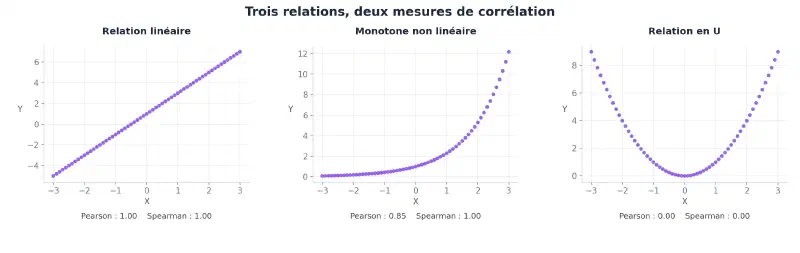
Les exemples suivants utilisent des données simulées sans bruit.
Afficher le code Python du graphique
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import pearsonr, spearmanr

# Trois relations à comparer
x = np.linspace(-3, 3, 61)

relations = {
    "Linéaire": 2 * x + 1,
    "Monotone non linéaire": np.exp(x / 1.2),
    "En U": x**2,
}

# Visualisation
fig, axes = plt.subplots(1, 3, figsize=(13, 4))

for ax, (nom, y) in zip(axes, relations.items()):
    r = pearsonr(x, y).statistic
    s = spearmanr(x, y).statistic

    ax.scatter(x, y, s=20)
    ax.set_title(f"{nom}\nPearson = {r:.2f} | Spearman = {s:.2f}")
    ax.set_xlabel("X")
    ax.set_ylabel("Y")
    ax.grid(alpha=0.2)

plt.tight_layout()
plt.show()
Relation linéaire#
$$ Y = 2X + 1 $$
Les deux variables suivent parfaitement une droite croissante.
- Pearson = 1
- Spearman = 1
Les deux coefficients détectent une association positive parfaite.
Relation monotone non linéaire#
$$ Y = e^{X/1.2} $$
La variable Y augmente toujours avec X, mais de manière exponentielle.
- Pearson ≈ 0,85
- Spearman = 1
Spearman détecte une association monotone parfaite, tandis que Pearson reste inférieur à 1 puisque la relation n’est pas linéaire.
Relation non monotone#
$$ Y = X^2 $$
Lorsque X passe de valeurs négatives à zéro, Y diminue. Puis Y augmente lorsque X devient positif.
Pour des observations réparties symétriquement autour de zéro :
- Pearson = 0
- Spearman = 0
Pourtant, Y est entièrement déterminé par X.
Une corrélation nulle n’implique donc pas une absence de relation.
3. Quel coefficient choisir ?#
| Critère | Pearson | Spearman |
|---|---|---|
| Type d’association | Linéaire | Monotone |
| Données utilisées | Valeurs | Rangs |
| Variables ordinales | Peu adapté | Adapté |
| Valeurs extrêmes | Très sensible | Moins sensible à leur amplitude |
| Relation monotone non linéaire | Peut être inférieur à 1 | Peut atteindre 1 |
En pratique :
- Pearson est adapté lorsqu’on souhaite quantifier une association linéaire entre deux variables quantitatives.
- Spearman est intéressant lorsque la relation semble monotone, lorsque les variables sont ordinales ou lorsque des valeurs extrêmes influencent fortement Pearson.
- Les deux peuvent être calculés lors d’une analyse exploratoire pour comparer leurs comportements.
Quelques précautions restent indispensables :
- Des coefficients proches ne prouvent pas que la relation est linéaire.
- Spearman est moins sensible à l’amplitude des valeurs extrêmes, mais n’est pas insensible aux observations atypiques.
- Aucun des deux coefficients ne permet de détecter correctement toutes les relations non monotones.
- Une corrélation ne démontre jamais, à elle seule, une relation causale.
Enfin, ni Pearson ni Spearman ne nécessitent une distribution normale des variables pour être calculés. Les hypothèses statistiques interviennent notamment lorsqu’on souhaite réaliser certains tests ou construire des intervalles de confiance.
4. Calculer les corrélations avec Python#
Avec SciPy, on peut calculer les deux coefficients entre deux variables :
from scipy.stats import pearsonr, spearmanr

x = df["surface"]
y = df["prix"]

pearson = pearsonr(x, y).statistic
spearman = spearmanr(x, y).statistic

print(f"Pearson : {pearson:.2f}")
print(f"Spearman : {spearman:.2f}")
Avec Pandas, on peut directement calculer les matrices de corrélation d’un DataFrame :
pearson = df.corr(method="pearson", numeric_only=True)
spearman = df.corr(method="spearman", numeric_only=True)
Ces coefficients permettent de repérer des associations intéressantes, mais leur interprétation doit toujours être complétée par une inspection graphique des données.
À retenir#
Pearson mesure une association linéaire. Spearman mesure une association monotone à partir des rangs.
Ils sont complémentaires, mais aucun ne décrit à lui seul toutes les relations possibles entre variables.
En analyse exploratoire, le bon réflexe reste de calculer, visualiser puis interpréter.
Une variable faiblement corrélée à une cible peut d’ailleurs rester utile en Machine Learning, notamment lorsque le modèle exploite des relations non linéaires ou des interactions.