Une valeur atypique (outlier) est une observation qui s’éloigne du comportement habituel des données.
Elle peut provenir d’une erreur de saisie, d’un problème de mesure ou d’un événement exceptionnel.
Une valeur atypique n’est donc pas nécessairement une erreur. Elle peut même représenter l’information la plus intéressante du jeu de données : fraude, panne industrielle ou événement extrême.
1. Les différents types d’anomalies#
On distingue notamment trois situations :
| Type | Description |
|---|---|
| Ponctuelle | Une observation est très différente des autres. |
| Contextuelle | Une observation est anormale uniquement dans un contexte particulier. |
| Collective | Un ensemble d’observations présente un comportement inhabituel. |
Une anomalie peut également être multivariée : chaque variable semble normale séparément, mais leur combinaison est inhabituelle.
Par exemple, un véhicule de deux ans, affichant 250 000 km et vendu 40 000 €, mérite peut-être une vérification.
Avant les méthodes statistiques, les règles métier permettent souvent de repérer les erreurs évidentes : âge négatif, date impossible ou unité incorrecte.
2. Détecter les valeurs atypiques#
L’écart interquartile (IQR)#
La méthode de Tukey repose sur les quartiles :
\[ IQR = Q_3 - Q_1 \]
Avec :
- \(Q_1\) : premier quartile (25 %) ;
- \(Q_3\) : troisième quartile (75 %).
Une observation est signalée comme atypique lorsqu’elle se situe en dehors de l’intervalle :
\[ [Q_1 - 1{,}5 \times IQR \ ; \ Q_3 + 1{,}5 \times IQR] \]
Cette règle est notamment utilisée dans les boîtes à moustaches (boxplots).
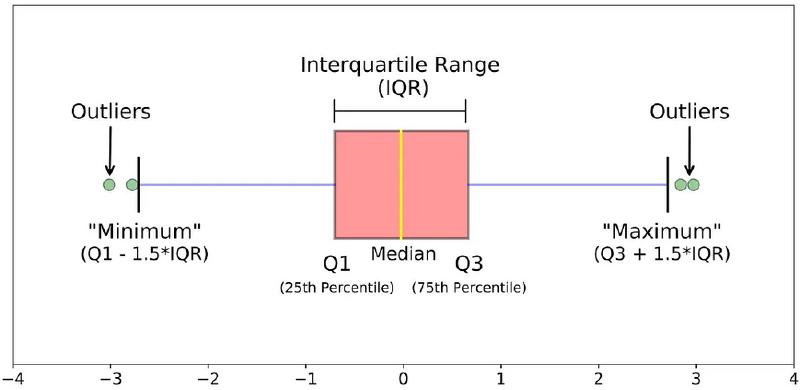
Le coefficient 1,5 est une convention statistique, pas une règle universelle. Une distribution très asymétrique peut naturellement produire de nombreuses observations au-delà de ces bornes.
Le Z-score#
Le Z-score mesure l’éloignement d’une observation à la moyenne, en nombre d’écarts-types :
\[ z = \frac{x - \mu}{\sigma} \]
Une règle fréquente consiste à signaler les observations avec \(|z| > 3\).
Cette méthode est simple, mais sensible aux valeurs extrêmes et à la forme de la distribution.
Les méthodes avancées#
Pour détecter des anomalies plus complexes, on peut notamment utiliser :
- Isolation Forest : recherche les observations facilement isolables par des séparations aléatoires.
- Local Outlier Factor (LOF) : compare la densité locale d’une observation à celle de ses voisins.
- Autoencodeurs : utilisent l’erreur de reconstruction d’un réseau de neurones comme indicateur d’anomalie.
Ces approches permettent notamment de travailler sur plusieurs variables simultanément.
3. Que faire des valeurs atypiques ?#
Détecter une valeur atypique ne signifie pas qu’il faut la supprimer.
| Situation | Traitement possible |
|---|---|
| Valeur rare, mais réelle | Conserver, éventuellement isoler ou signaler. |
| Erreur identifiée | Corriger à partir d’une source fiable. |
| Valeur impossible, sans correction fiable | Passer en valeur manquante ou exclure l’observation. |
| Valeur réelle, mais très influente | Envisager une méthode statistique robuste. |
Il faut notamment distinguer une valeur atypique d’une valeur influente.
Prenons cinq salaires mensuels :
2 000, 2 100, 2 200, 2 300, 20 000
| Indicateur | Sans 20 000 € | Avec 20 000 € |
|---|---|---|
| Moyenne | 2 150 € | 5 720 € |
| Médiane | 2 150 € | 2 200 € |
Le dernier salaire peut être parfaitement réel, mais il influence fortement la moyenne.
Plutôt que de supprimer cette observation, on peut privilégier des statistiques robustes comme la médiane et l’IQR.
D’autres traitements existent, notamment la winsorisation, qui ramène les valeurs extrêmes à des seuils définis. Elle modifie toutefois les données et doit être justifiée.
4. Exemple avec pandas#
Détection simple à partir de l’IQR :
q1 = df["prix"].quantile(0.25)
q3 = df["prix"].quantile(0.75)

iqr = q3 - q1

borne_inf = q1 - 1.5 * iqr
borne_sup = q3 + 1.5 * iqr

# Observations à examiner
outliers = df[
    (df["prix"] < borne_inf) |
    (df["prix"] > borne_sup)
]
Le résultat identifie les observations à examiner. Il ne faut pas les supprimer automatiquement.
À retenir#
Une valeur atypique peut être une erreur ou une information importante. Les méthodes statistiques permettent de la repérer, mais c’est le contexte qui permet de décider quoi en faire.
Références#
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley. Ouvrage fondateur sur l’analyse exploratoire, les boxplots et les méthodes robustes.
- Aggarwal, C. C. (2016). Outlier Analysis. Springer. Méthodes de détection des anomalies.
- Wilcox, R. R. (2021). Introduction to Robust Estimation and Hypothesis Testing. Academic Press. Statistiques robustes et influence des valeurs extrêmes.